
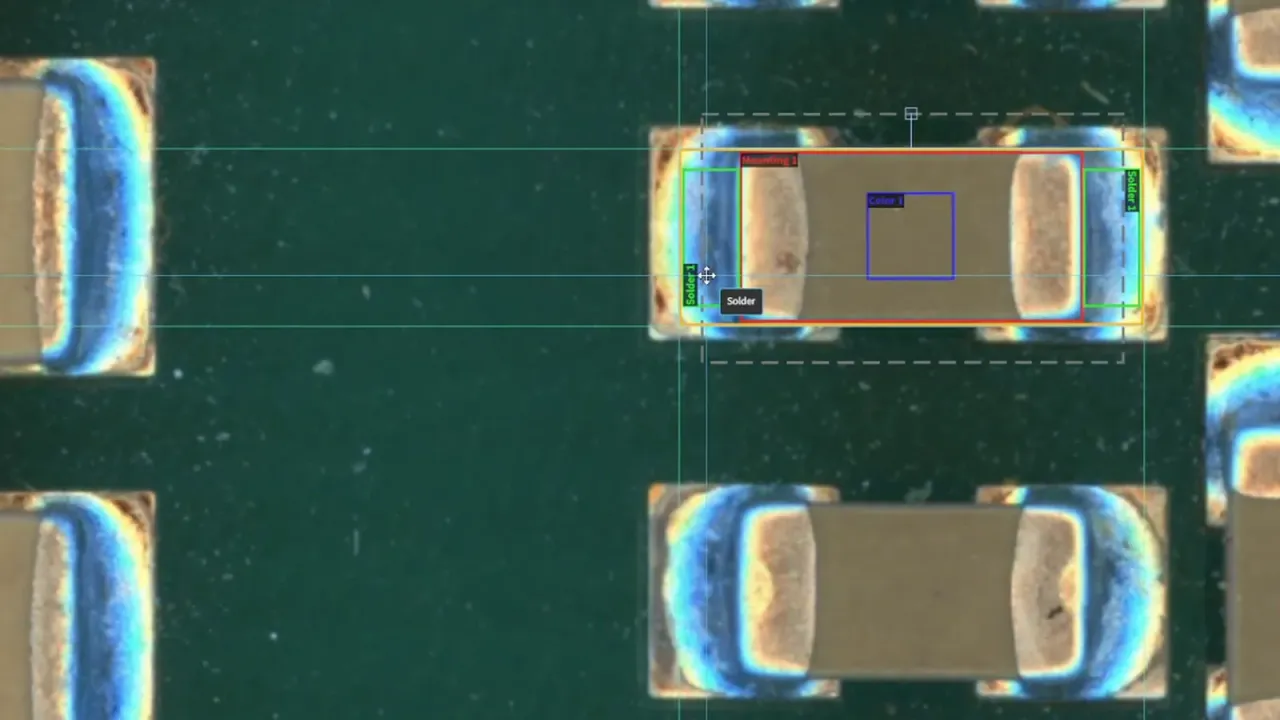
問一條產線上的質檢工程師「你們有多少種缺陷」,得到的數字通常是二三十;再追問「去年新出現過幾種以前沒見過的」,答案往往還有三五種。缺陷的形態沒有邊界,新的工藝、新的來料、新的批次都會帶來新的壞法。而良品不同:一個元件的正常形態是有邊界的,這正是少樣本自訓練成立的前提。
本文用到的 ACI 是「自動認知檢測」(Automated Cognitive Inspection)的縮寫—— AI AOI 的下一代提法:保留 A(自動)與 I(檢測),把 O(光學)換成 C(認知),因為判定依據是認知而不是成像方式。完整論證見從 AI AOI 到 ACI。
一、缺陷庫這條路為什麼越走越窄
規則式與早期學習式檢測都要先有缺陷庫:把已知的壞法收集齊、標註好,模型學會識別它們。這條路在缺陷種類穩定、批次大、產品長期不變的場景裡是有效的。問題出在「已知」兩個字上——它只覆蓋你見過的那些。
更現實的困難是冷啟動:一條新線剛投產時,缺陷樣本恰恰最少,而這正是最需要檢測的時候。為了湊夠樣本,常見做法是人為製造缺陷件,或者先用人工全檢跑幾周收集。前者製造出來的缺陷與真實工藝缺陷未必同形,後者則把上線時間推後了幾周。
二、開集與閉集
把這件事抽象一層就清楚了:缺陷集合是開的——你無法列舉完;良品集合是閉的——一個元件的正常形態由設計與工藝共同約束,有明確邊界。
在開集上做分類,模型本質上是在學「我見過的那些壞」,對沒見過的壞沒有保證;在閉集上做建模,模型學的是「正常長什麼樣」,任何偏離正常的東西都落在異常側,不要求事先見過。這是兩種完全不同的問題,難度也不同——後者可收斂,前者不能。
這條方向上的差異,是把 AOI 改稱 ACI 的理由之一,延伸閱讀見從 AI AOI 到 ACI。
窮舉壞法是個沒有終點的任務;描述好的樣子是個有終點的任務。
三、換方向之後,三件事同時變了
- 冷啟動:不必等缺陷積累。一塊良品樣板即可完成建模上線,新線投產當天就能開檢。
- 換型:換新型號時不需要重新收集缺陷資料,因為要描述的是新型號的正常形態,而那塊良品當場就有。
- 長尾缺陷:第一次出現的壞法不需要先被見過才能被抓到——它只要偏離正常形態即可。這是缺陷庫路線最難補的一塊。
三件事變的是同一個東西:判據不再依賴「見過多少種壞」,而依賴「把好描述得多準」。
四、那缺陷標註是不是就不用做了
不是。良品建模解決的是「判它異常」,而產線還需要「說清是哪一類異常」——分級、歸類、工藝追溯都要這個。差別在於標註的位置與數量:從「上線前必須先有幾千張缺陷圖」變成「上線後按實際出現的缺陷逐步補類別」。
這個順序的價值在於,標註的對象是真實發生過的缺陷,而不是為了湊數造出來的。標註量也從一次性的大投入變成隨產線節奏的小投入。
五、良品要挑什麼樣的
少樣本不等於隨便一塊。實踐中幾條經驗:
- 取工藝穩定期的件,不取調機階段的件——調機期的「良品」本身就帶著未收斂的工藝特徵。
- 覆蓋允許範圍內的正常變異:同一型號不同批次的來料色差、允許公差內的位置偏移,這些都該在良品集裡出現,否則模型會把它們當異常。
- 不混入待判件:對是否合格有爭議的件先由工藝定性,定性之前不進良品集。
這幾條決定的是「正常形態」這條邊界畫得準不準。邊界畫歪了,後面所有判定都跟著歪——這是少樣本路線上最需要人參與的一步,也是唯一一步。
六、和判定層的關係
良品建模改變的是模型怎麼學,判定層改變的是判據掛在什麼上。兩者是配套的:只有當判據表述為「這個元件是否處在正常形態範圍內」時,良品建模的輸出才直接可用;如果判據仍然是「與標準圖的畫素差」,那麼良品建模得到的也只是一張更好的標準圖,受光照與批次影響的老問題一個都沒解決。
七、什麼時候良品建模不夠用
同樣要說清不適用情形:
- 缺陷與良品在所用成像方式下不可分:比如內部空洞在可見光下根本不成像。這時要解的是成像問題,不是建模問題。
- 正常形態本身沒有收斂:研發試產階段工藝天天在調,此時「什麼算正常」還沒定義,建模會鎖住一個錯誤的基準。
- 判級依賴上下文而非外觀:某些缺陷是否判退取決於位置、客戶、批次用途,這部分要由規則補,模型給不出。
前兩條是「現在還不該上」,第三條是「模型之外還要配規則」。三者都不否定良品建模本身,但會決定它在這條線上能覆蓋多少。
八、從缺陷庫遷過來的實際順序
已經積累了幾年缺陷庫的產線,不必把它丟掉。可行的順序是並行一段:
- 第一步,用良品集建一版模型,與現有缺陷庫模型並行跑,兩邊都不接停機動作,只記錄判定差異。
- 第二步,把差異逐條歸因:哪些是良品模型多報的(良品集沒覆蓋到的正常變異),哪些是缺陷庫模型漏掉的(沒見過的壞法)。這一步產出的清單比任何指標都有說服力。
- 第三步,按歸因結果補良品集,而不是補缺陷庫。補完再跑一輪差異,直到多報的部分收斂。
- 第四步,切換判定主責,缺陷庫模型轉為分級與歸類用途——它對「這是哪一類缺陷」仍然有效,只是不再承擔「有沒有缺陷」這個判斷。
這個順序的關鍵在第二步:差異清單讓兩條路線的邊界變得可見,而不是靠誰的準確率數字更好看來決策。
九、怎麼判斷良品集的邊界畫對了
良品集畫得準不準,不能靠模型自己的置信度回答——那是自證。可用的判據有三條,都在模型之外:
- 跨批次一致性:用 A 批次的良品建模,拿 B 批次的良品去過。若 B 批次被大量判異常,說明良品集沒覆蓋批次間的正常變異,邊界畫窄了。
- 複核翻轉率:人工複核把模型判的異常推翻的比例,按元件類型聚合。某一類元件的翻轉集中,說明這類元件的正常形態沒描述清楚。
- 爭議件去向:把工藝定性為「可接受」的爭議件單獨留一組,不進良品集,建完模再拿它們去過。這組的判定結果直接反映邊界落在哪一側。
三條的共同點是:判據落在模型之外的事實上——另一批次的良品、人工複核的結論、工藝的定性。用模型自己的輸出去證明模型對,是這條路線上最容易犯的錯。
判定層與成像方式解耦是同一條路線上的另一半,見一條產線上不止一種成像。
常見問題
只用良品建模,會不會把真缺陷當成正常變異放過去?
取決於良品集是否覆蓋了允許範圍內的正常變異。覆蓋不足時模型會把正常變異判成異常(誤報偏高),覆蓋過度——把有爭議的件混進良品集——才會放過真缺陷。所以良品集的入選標準要由工藝定性,這一步不能省。
換型時真的不用重新收集資料嗎?
不用收集缺陷資料,但需要新型號的良品樣板。要描述的是新型號的正常形態,而那塊樣板在換型現場本來就有。
這和「預訓練模型直接拿來用」是一回事嗎?
不是。預訓練模型提供的是通用的視覺特徵能力,而正常形態是這條線、這個型號特有的,必須在現場建模。跳過現場建模直接用通用模型,判的是「一般意義上的異常」,不是「這塊板上的異常」。
本場景的完整方案:AI AOI 軟體系統 的完整檢測方案
本文由人工智慧生成。文中客戶案例為基於產品真實能力的模擬場景,成效數字為示例性質;官方標定口徑以產品頁為準。