
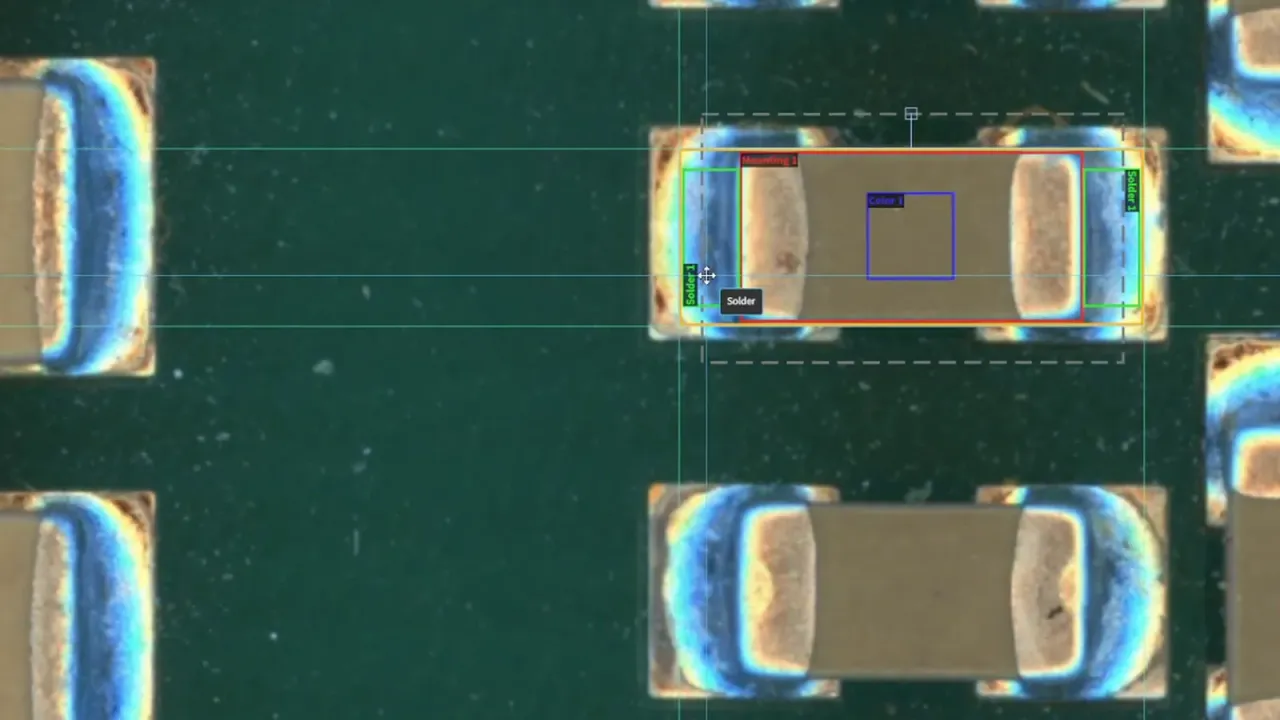
问一条产线上的质检工程师「你们有多少种缺陷」,得到的数字通常是二三十;再追问「去年新出现过几种以前没见过的」,答案往往还有三五种。缺陷的形态没有边界,新的工艺、新的来料、新的批次都会带来新的坏法。而良品不同:一个元件的正常形态是有边界的,这正是少样本自训练成立的前提。
本文用到的 ACI 是「自动认知检测」(Automated Cognitive Inspection)的缩写—— AI AOI 的下一代提法:保留 A(自动)与 I(检测),把 O(光学)换成 C(认知),因为判定依据是认知而不是成像方式。完整论证见从 AI AOI 到 ACI。
一、缺陷库这条路为什么越走越窄
规则式与早期学习式检测都要先有缺陷库:把已知的坏法收集齐、标注好,模型学会识别它们。这条路在缺陷种类稳定、批量大、产品长期不变的场景里是有效的。问题出在「已知」两个字上——它只覆盖你见过的那些。
更现实的困难是冷启动:一条新线刚投产时,缺陷样本恰恰最少,而这正是最需要检测的时候。为了凑够样本,常见做法是人为制造缺陷件,或者先用人工全检跑几周收集。前者制造出来的缺陷与真实工艺缺陷未必同形,后者则把上线时间推后了几周。
二、开集与闭集
把这件事抽象一层就清楚了:缺陷集合是开的——你无法枚举完;良品集合是闭的——一个元件的正常形态由设计与工艺共同约束,有明确边界。
在开集上做分类,模型本质上是在学「我见过的那些坏」,对没见过的坏没有保证;在闭集上做建模,模型学的是「正常长什么样」,任何偏离正常的东西都落在异常侧,不要求事先见过。这是两种完全不同的问题,难度也不同——后者可收敛,前者不能。
这条方向上的差异,是把 AOI 改称 ACI 的理由之一,延伸阅读见从 AI AOI 到 ACI。
穷举坏法是个没有终点的任务;描述好的样子是个有终点的任务。
三、换方向之后,三件事同时变了
- 冷启动:不必等缺陷积累。一块良品样板即可完成建模上线,新线投产当天就能开检。
- 换型:换新型号时不需要重新收集缺陷数据,因为要描述的是新型号的正常形态,而那块良品当场就有。
- 长尾缺陷:第一次出现的坏法不需要先被见过才能被抓到——它只要偏离正常形态即可。这是缺陷库路线最难补的一块。
三件事变的是同一个东西:判据不再依赖「见过多少种坏」,而依赖「把好描述得多准」。
四、那缺陷标注是不是就不用做了
不是。良品建模解决的是「判它异常」,而产线还需要「说清是哪一类异常」——分级、归类、工艺追溯都要这个。差别在于标注的位置与数量:从「上线前必须先有几千张缺陷图」变成「上线后按实际出现的缺陷逐步补类别」。
这个顺序的价值在于,标注的对象是真实发生过的缺陷,而不是为了凑数造出来的。标注量也从一次性的大投入变成随产线节奏的小投入。
五、良品要挑什么样的
少样本不等于随便一块。实践中几条经验:
- 取工艺稳定期的件,不取调机阶段的件——调机期的「良品」本身就带着未收敛的工艺特征。
- 覆盖允许范围内的正常变异:同一型号不同批次的来料色差、允许公差内的位置偏移,这些都该在良品集里出现,否则模型会把它们当异常。
- 不混入待判件:对是否合格有争议的件先由工艺定性,定性之前不进良品集。
这几条决定的是「正常形态」这条边界画得准不准。边界画歪了,后面所有判定都跟着歪——这是少样本路线上最需要人参与的一步,也是唯一一步。
六、和判定层的关系
良品建模改变的是模型怎么学,判定层改变的是判据挂在什么上。两者是配套的:只有当判据表述为「这个元件是否处在正常形态范围内」时,良品建模的输出才直接可用;如果判据仍然是「与标准图的像素差」,那么良品建模得到的也只是一张更好的标准图,受光照与批次影响的老问题一个都没解决。
七、什么时候良品建模不够用
同样要说清不适用情形:
- 缺陷与良品在所用成像方式下不可分:比如内部空洞在可见光下根本不成像。这时要解的是成像问题,不是建模问题。
- 正常形态本身没有收敛:研发试产阶段工艺天天在调,此时「什么算正常」还没定义,建模会锁住一个错误的基准。
- 判级依赖上下文而非外观:某些缺陷是否判退取决于位置、客户、批次用途,这部分要由规则补,模型给不出。
前两条是「现在还不该上」,第三条是「模型之外还要配规则」。三者都不否定良品建模本身,但会决定它在这条线上能覆盖多少。
八、从缺陷库迁过来的实际顺序
已经积累了几年缺陷库的产线,不必把它丢掉。可行的顺序是并行一段:
- 第一步,用良品集建一版模型,与现有缺陷库模型并行跑,两边都不接停机动作,只记录判定差异。
- 第二步,把差异逐条归因:哪些是良品模型多报的(良品集没覆盖到的正常变异),哪些是缺陷库模型漏掉的(没见过的坏法)。这一步产出的清单比任何指标都有说服力。
- 第三步,按归因结果补良品集,而不是补缺陷库。补完再跑一轮差异,直到多报的部分收敛。
- 第四步,切换判定主责,缺陷库模型转为分级与归类用途——它对「这是哪一类缺陷」仍然有效,只是不再承担「有没有缺陷」这个判断。
这个顺序的关键在第二步:差异清单让两条路线的边界变得可见,而不是靠谁的准确率数字更好看来决策。
九、怎么判断良品集的边界画对了
良品集画得准不准,不能靠模型自己的置信度回答——那是自证。可用的判据有三条,都在模型之外:
- 跨批次一致性:用 A 批次的良品建模,拿 B 批次的良品去过。若 B 批次被大量判异常,说明良品集没覆盖批次间的正常变异,边界画窄了。
- 复核翻转率:人工复核把模型判的异常推翻的比例,按元件类型聚合。某一类元件的翻转集中,说明这类元件的正常形态没描述清楚。
- 争议件去向:把工艺定性为「可接受」的争议件单独留一组,不进良品集,建完模再拿它们去过。这组的判定结果直接反映边界落在哪一侧。
三条的共同点是:判据落在模型之外的事实上——另一批次的良品、人工复核的结论、工艺的定性。用模型自己的输出去证明模型对,是这条路线上最容易犯的错。
判定层与成像方式解耦是同一条路线上的另一半,见一条产线上不止一种成像。
常见问题
只用良品建模,会不会把真缺陷当成正常变异放过去?
取决于良品集是否覆盖了允许范围内的正常变异。覆盖不足时模型会把正常变异判成异常(误报偏高),覆盖过度——把有争议的件混进良品集——才会放过真缺陷。所以良品集的入选标准要由工艺定性,这一步不能省。
换型时真的不用重新收集数据吗?
不用收集缺陷数据,但需要新型号的良品样板。要描述的是新型号的正常形态,而那块样板在换型现场本来就有。
这和「预训练模型直接拿来用」是一回事吗?
不是。预训练模型提供的是通用的视觉特征能力,而正常形态是这条线、这个型号特有的,必须在现场建模。跳过现场建模直接用通用模型,判的是「一般意义上的异常」,不是「这块板上的异常」。
本场景的完整方案:AI AOI 软件系统 的完整检测方案
本文由人工智能生成。文中客户案例为基于产品真实能力的模拟场景,成效数字为示例性质;官方标定口径以产品页为准。