
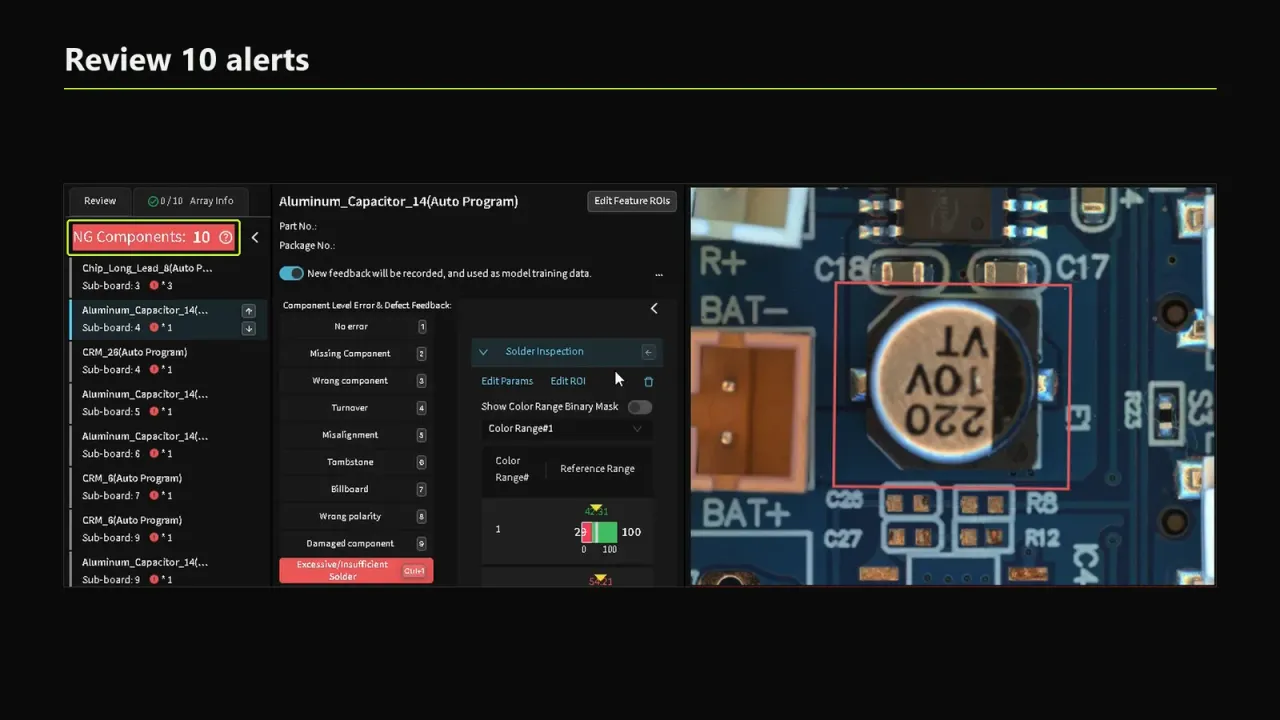
「報一次誤報,模型學一次」這句話本身沒問題,但它容易被讀成一個自動過程:報了就會變好。實際發生的事有三段——歸因、入集、驗證——任何一段缺失,反饋就只是在記賬。更要緊的是,這條路是雙向的:同一個機制既能把邊界推向更準,也能把它推向放過真缺陷,而後一種每次都讓誤報數字更好看。
本文用到的 ACI 是「自動認知檢測」(Automated Cognitive Inspection)的縮寫—— AI AOI 的下一代提法:保留 A(自動)與 I(檢測),把 O(光學)換成 C(認知),因為判定依據是認知而不是成像方式。完整論證見從 AI AOI 到 ACI。
一、一次翻轉到底給了模型什麼
先看資訊量。一次複核翻轉說的是:某一張圖上的某一個判定,人認為反了。這是一個樣本上的一個位元,憑它本身改不動任何模型。
讓它變得有用的是歸因。「這個位號的這張圖是好的」幾乎沒有價值,因為這個位號下次就不在那兒了;「這一類元件在這種表面狀態下是好的」才有價值,因為這句話對以後所有同類元件都成立。
所以反饋的第一步不是訓練,是歸類。歸不到類的翻轉,不管記錄得多完整,都只是一條日誌。
二、學習的單位是元件類別,不是那張圖
判據掛在元件上之後,良品的描述是按元件類別組織的。一次翻轉做的事,是把這個樣本收回它所屬類別的良品集,那一類的邊界因此往外推一點。
推多少由分母決定。類別裡已經有幾百個樣本時,一次翻轉幾乎推不動;只有十幾個時,一次翻轉的影響很大。
新料號反饋見效快、成熟料號「沒反應」——不是失靈,是分母不同。
這解釋了產線上一個常見的困惑。它也提示了一件事:對成熟類別,單條反饋不該被期待有立竿見影的效果,該看的是一段時間內同類翻轉的聚集位置。
三、「越用越準」需要三個條件
這句話成立有前提,三個條件缺一條,反饋學習就退化成一張誤報記錄表:
- 可歸因:翻轉要能落到一個元件類別與一種變異類型上。複核只寫「OK」時它落不下去。
- 可留存:樣本本身要留下來,不能只留結論。只留結論等於知道答案不知道題目,重訓時無從用起。
- 可驗證:更新之後要能量出變了什麼。量不出來就分不清變準了還是變鬆了——而這兩者的短期表象完全一樣。
三條裡最常缺的是第一條,而它恰恰是唯一一條要在複核工位上解決的:介面上有沒有讓人順手選一個原因,決定了後面兩條有沒有原料。
四、反向的風險:反饋也能教會模型放過真缺陷
誤報的定義把裁決權交給了複核,而複核會錯。趕產量的那幾個班次裡被「先放行」的件,如果照常進了良品集,邊界就往真缺陷那一側推了一段。
這種漂移有三個性質,合起來讓它很難被發現:它是單向的,因為糾正它需要有人主動把件退回來,而沒有人會去退一個已經判好的件;它是緩慢的,每次只推一點;而且它每次都讓誤報數字變得更好看。
換句話說,模型學壞的過程,在所有日常看的指標上都表現為進步。它不會自己暴露,通常要到某一次批次流出才被回頭查出來。
五、所以必須有一份凍結的對照集
應對辦法只有一個方向:留一批樣本,不參與任何反饋更新,其中包含已經確認過的真缺陷。每次更新之後在它上面跑一遍,只問一件事——原來抓得到的,現在還抓不抓得到。
這份集子的全部價值在「凍結」二字。一旦它開始跟著反饋一起更新,它就和被測對象同源了,判別力歸零:它會對任何變化都報告一切正常,而那份報告與真正的一切正常逐字相同。
這是「批改與驗收不能共用同一依據」這條規矩在反饋學習上的具體形態。凍結集要按時間或按產線與訓練資料切開,並且它的更換要走一次顯式決定,不能順手補幾個進去。
六、反饋修不了的兩類問題
分清這兩類,能省掉大量「為什麼一直學不會」的排查:
- 成像上看不見:缺陷在當前照明、視角或解析度下根本沒有留下訊號。再多反饋也學不出不存在的東西,這一類要改的是成像不是模型。
- 判據本身是幾何規格:共面度、高度差這類有明確公差,規則層直接給答案更可靠,不該交給學習去逼近。
有一個簡單的分辨辦法:把那幾個漏掉的件調出來,讓人在同一張圖上看。人也看不出來,就是第一類;人一眼能看出來而模型沒報,才輪到反饋學習。
七、誰有權教它
反饋是一種寫權限——它改變的不是這一件的判定,是之後所有同類件的判定。按寫權限對待它,有三件事要安排:
- 角色分開:報誤報的人和批准樣本入集的人不必是同一個,尤其在趕產量的時候。
- 成批生效而不是逐條即時:即時生效聽起來快,但它讓「一次誤判入集」與「產線判定變化」之間沒有任何緩衝。
- 有版本、可回退:說不清某次更新改了什麼的系統,出問題時只能整體推倒重來。
八、怎麼驗證一次反饋真的生效了
不能只看「後來沒再報」。那件東西可能根本沒再出現過,而「沒出現」與「學會了」在報表上是同一個數字。
可用的做法是兩件一起做:把同類的歷史樣本調出來重跑,看判定有沒有按預期變化——這一件證明它學到了;再在凍結對照集上跑一遍,確認原來抓得到的還抓得到——這一件證明它沒學壞。
只做前一件,驗的是學會沒有;只做後一件,驗的是有沒有學壞。兩件都做,才回答得了「這次更新值不值得發」。
九、什麼時候不必上反饋學習
不適用情形同樣要說清:
- 誤報總量本來就低:複核不是瓶頸時,這套機制的維護成本換不回等量的收益。
- 產品生命週期很短:模型還沒積累到能看出聚集,機種就換了,分母永遠起不來。
- 現場沒有穩定的複核流程:反饋學習的輸入質量上限就是複核質量,複核隨意時它只會更快地學壞——這種情況下不上反而更安全。
第三條值得強調:反饋學習不是一個能獨立運轉的模組,它是把人的判斷規模化。人的判斷不穩時,規模化放大的是不穩。
良品集為什麼是閉集、邊界往哪推,見缺陷是開集,良品是閉集。
「不能用同一批資料既調又驗」的完整論證,見閾值是一條曲線,不是一個數字。
這一步在產品上的樣子,見反饋學習。
常見問題
報一次誤報,模型立刻就變了嗎?
通常不會,也不該。一次翻轉是一個樣本上的一個位元,它對邊界的影響由那一類元件裡已有的樣本數決定——成熟類別裡幾乎推不動,新料號上影響很大。而且即時生效會讓「一次誤判入集」和「產線判定變化」之間沒有緩衝,成批生效加一次批准更穩妥。
反饋學習會不會把模型教壞?
會。誤報的裁決權在複核手裡,而趕產量時被先放行的件如果照常進良品集,邊界就往真缺陷那一側推。這種漂移單向、緩慢,而且每次都讓誤報數字更好看,所以不會自己暴露。唯一的對策是留一份不參與更新的凍結對照集,每次更新後確認原來抓得到的還抓得到。
怎麼證明一次反饋真的生效了?
不能只看「後來沒再報」——那件東西可能根本沒再出現。要兩件一起做:把同類歷史樣本調出來重跑,看判定有沒有按預期變化(證明學到了);再在凍結對照集上跑一遍,確認沒有退步(證明沒學壞)。只做一件都回答不了這次更新該不該發。
本場景的完整方案:AI AOI 軟體系統 的完整檢測方案
本文由人工智慧生成。文中客戶案例為基於產品真實能力的模擬場景,成效數字為示例性質;官方標定口徑以產品頁為準。